O que é o cabeçalho X-Robots-Tag e como controlar a indexação
Por Tiago CostaAtualizado em 2 de julho de 2026
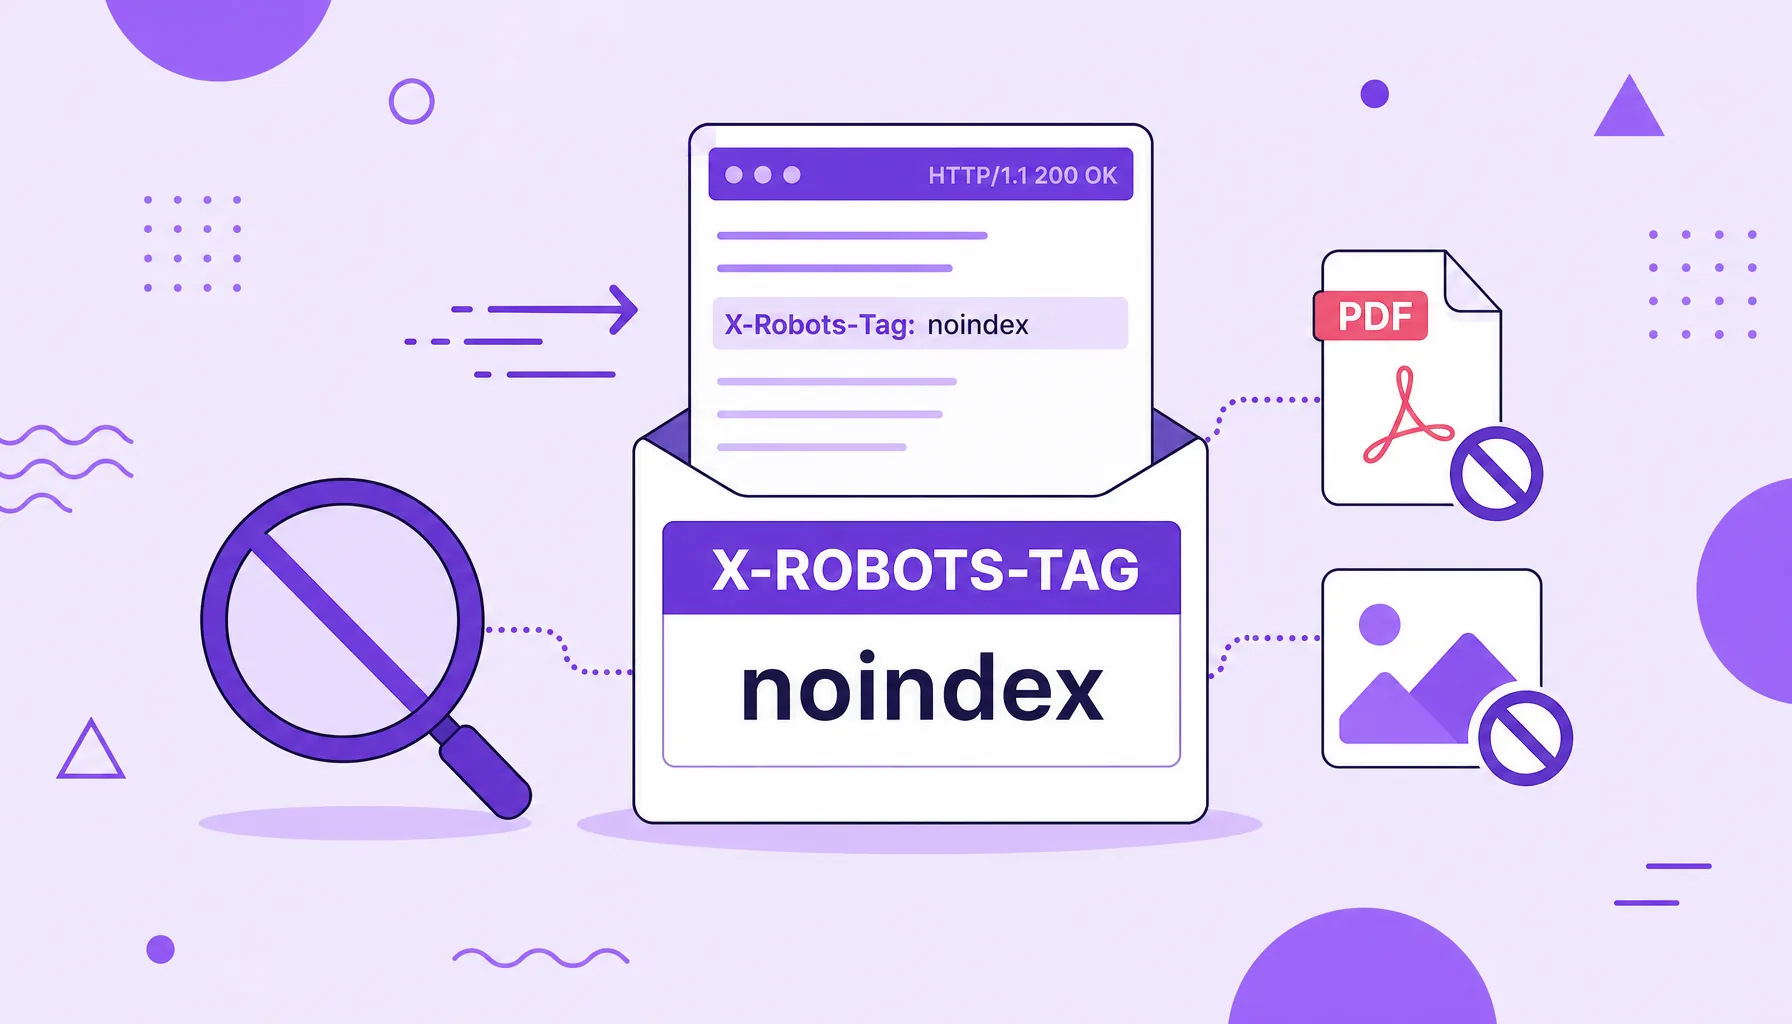
O X-Robots-Tag é um cabeçalho HTTP que controla como o buscador indexa uma URL. Na prática, ele:
- viaja na resposta do servidor, fora do HTML da página;
- aceita as mesmas diretivas da meta robots, como noindex e nofollow;
- é a única forma de aplicar noindex em PDFs, imagens e outros arquivos não HTML;
- permite aplicar regras em massa por tipo de arquivo no servidor.
O que é o cabeçalho X-Robots-Tag
O X-Robots-Tag é um cabeçalho HTTP, ou seja, uma linha de informação que o servidor envia junto com a resposta de uma URL, antes mesmo do conteúdo em si. Nesse cabeçalho, você pode incluir diretivas de indexação que dizem aos mecanismos de busca como tratar aquela página ou arquivo: se pode indexar, se deve seguir os links, se pode exibir uma versão em cache e assim por diante.
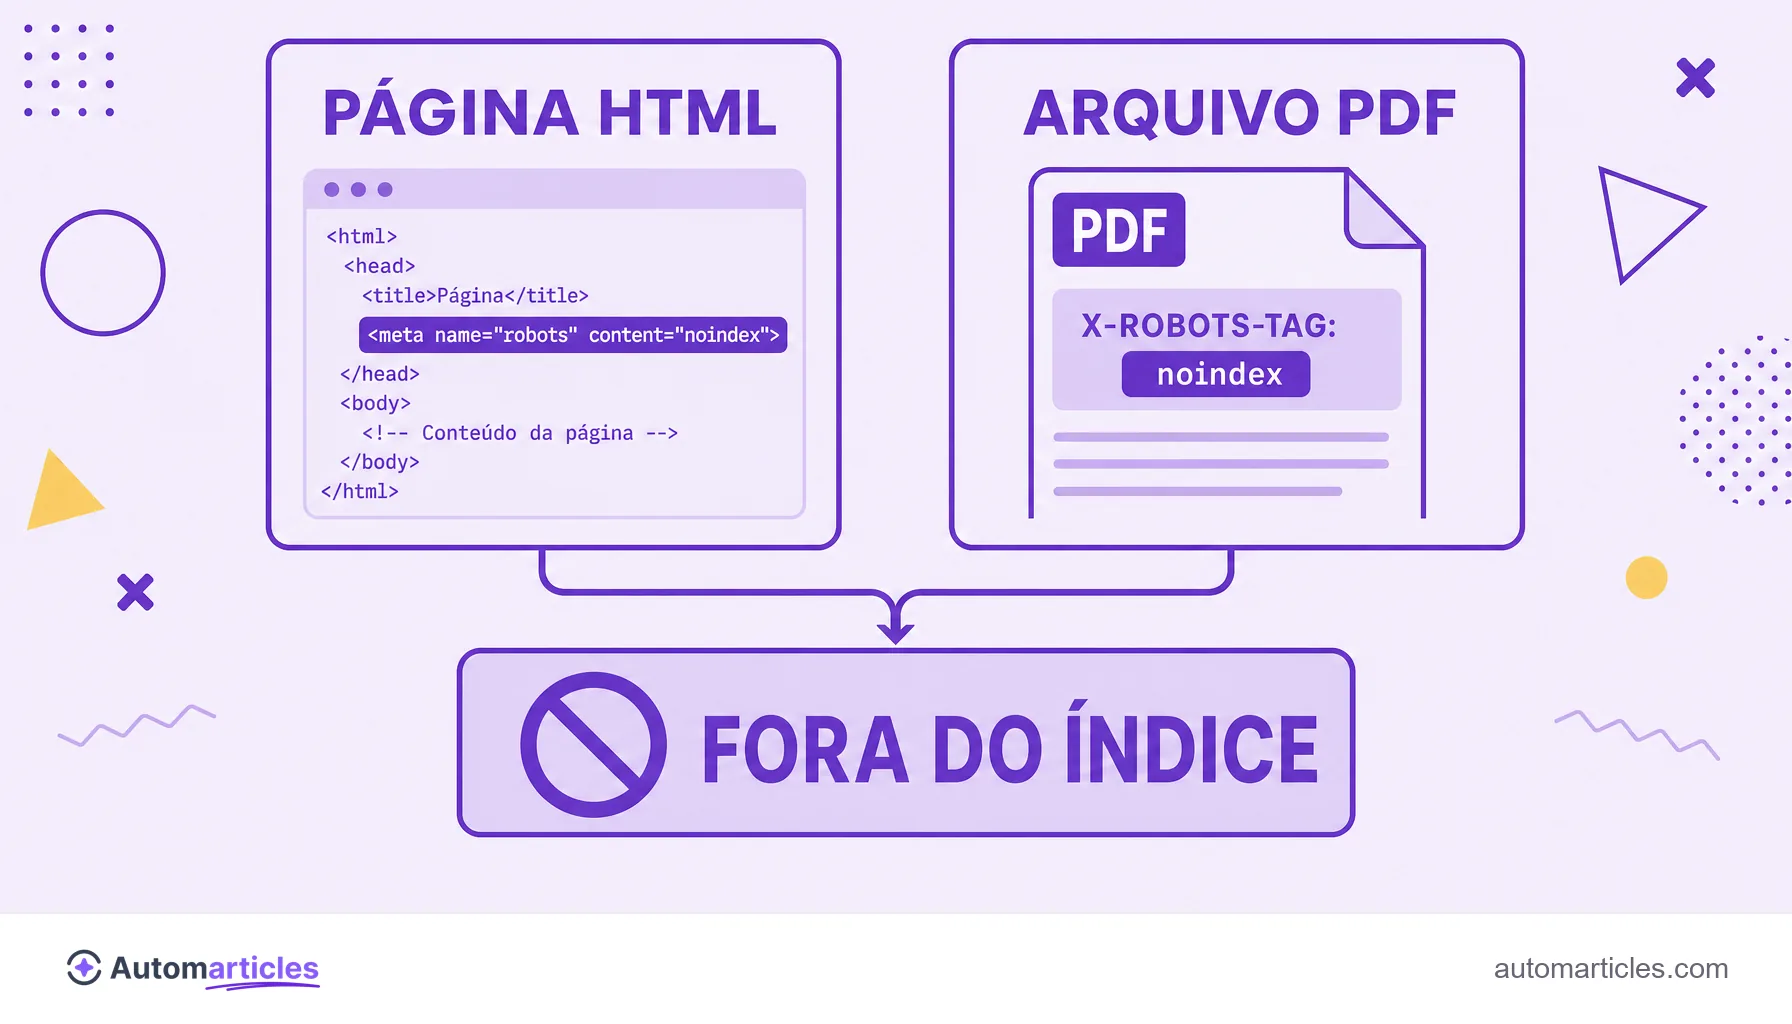
A diferença central em relação à famosa meta tag robots é onde a instrução mora. A meta tag fica dentro do HTML, na seção head da página. Já o X-Robots-Tag fica na resposta do servidor, num nível anterior ao conteúdo. As duas conseguem o mesmo efeito sobre a indexação, mas por caminhos diferentes.
Essa distinção não é um detalhe técnico sem importância. Ela resolve um problema real: como impedir a indexação de arquivos que não têm HTML, como um PDF ou uma imagem. Sem uma seção head para receber uma meta tag, esses arquivos só podem ser controlados pelo cabeçalho HTTP.
X-Robots-Tag x meta tag robots: quando usar cada um
As duas ferramentas entregam as mesmas diretivas, então a escolha depende do que você precisa controlar e de onde é mais prático aplicar a regra:
- Meta tag robots: ideal para páginas HTML individuais. Basta inserir a linha <meta name="robots" content="noindex"> no head do documento. É simples e não exige acesso ao servidor.
- X-Robots-Tag: ideal para arquivos não HTML (PDFs, imagens, vídeos) e para aplicar regras em massa. Como fica no servidor, você pode, por exemplo, mandar noindex para todos os PDFs de uma pasta de uma vez só.
A tabela abaixo resume as diferenças práticas entre as duas:
| Critério | Meta tag robots | X-Robots-Tag |
|---|---|---|
| Onde fica | No HTML, no head da página | No cabeçalho HTTP, no servidor |
| Tipos de arquivo | Só páginas HTML | Qualquer arquivo (HTML, PDF, imagem, vídeo) |
| Aplicação em massa | Uma página por vez | Em massa, por pasta ou padrão de URL |
| Acesso ao servidor | Não exige | Exige configurar o servidor |
| Facilidade | Mais simples de aplicar | Pede um pouco mais de conhecimento técnico |
Vale reforçar uma regra que confunde muita gente: tanto a meta tag quanto o X-Robots-Tag só funcionam se o buscador conseguir rastrear a URL e ler a instrução. Se você bloquear a mesma página no robots.txt, o robô nunca chega a ver o cabeçalho, e a diretiva de noindex é ignorada. Bloqueio de rastreamento e diretiva de indexação são coisas distintas que não devem ser combinadas na mesma URL.
Quais valores o X-Robots-Tag aceita
O X-Robots-Tag reconhece as mesmas diretivas da meta tag robots, e você pode combinar mais de uma, separadas por vírgula. As mais usadas:
| Valor | O que diz ao buscador |
|---|---|
| noindex | Não incluir esta URL nos resultados de busca. |
| nofollow | Não seguir os links contidos naquele recurso. |
| none | Atalho para noindex e nofollow juntos. |
| noarchive | Não exibir uma versão em cache do recurso. |
| nosnippet | Não mostrar trecho de texto nem prévia no resultado. |
| unavailable_after | Parar de indexar a URL depois de uma data definida. |
Também é possível direcionar a diretiva para um robô específico, nomeando o agente antes do valor (por exemplo, aplicar a regra só ao Googlebot). Essa flexibilidade faz do X-Robots-Tag uma ferramenta poderosa para quem gerencia muitos tipos de arquivo diferentes.
Como configurar o X-Robots-Tag no servidor
Como o X-Robots-Tag vive na resposta HTTP, a configuração é feita no servidor web, não no conteúdo. Os caminhos mais comuns:
- Apache: no arquivo de configuração ou no .htaccess, uma regra do tipo Header set X-Robots-Tag "noindex" pode ser combinada com um filtro por extensão para atingir só os PDFs, por exemplo.
- Nginx: dentro do bloco do servidor, a diretiva add_header X-Robots-Tag "noindex"; aplica a regra às URLs que você especificar.
- WordPress: plugins de SEO permitem marcar tipos de conteúdo com noindex, e alguns já cuidam do cabeçalho para arquivos de mídia sem você tocar no servidor.
O ponto de atenção é sempre o mesmo: aplicar a regra ao alvo certo. Um filtro mal configurado pode acabar mandando noindex para páginas importantes, então cada mudança pede um teste antes de ir para produção. Errar aqui derruba páginas inteiras da busca sem aviso.
Casos de uso: PDFs, imagens e arquivos não HTML
É nos arquivos que não são páginas HTML que o X-Robots-Tag brilha, porque neles a meta tag simplesmente não existe. Situações típicas:
- PDFs internos: catálogos, manuais e materiais que você não quer competindo nos resultados com as páginas do site.
- Imagens sensíveis: arquivos que devem ficar acessíveis a quem tem o link, mas fora da busca de imagens.
- Planilhas e documentos: exportações e relatórios que geram conteúdo duplicado ou de baixo valor para a busca.
- Áreas de download: pastas inteiras que fazem mais sentido fora do índice.
Vale lembrar que essas diretivas fazem parte de um universo bem consolidado. Segundo o levantamento do Web Almanac do HTTP Archive, em 2024 a diretiva noindex estava presente em cerca de 4,7% das páginas em desktop e 3,9% em dispositivos móveis, sinal de que o controle de indexação, seja por meta tag, seja por cabeçalho, é uma prática comum na web. Para complementar, o texto alternativo segue sendo o caminho para descrever imagens que você de fato quer indexar.
Como verificar e evitar erros com o X-Robots-Tag
Como o cabeçalho não aparece no HTML visível, é fácil aplicá-lo sem querer ou esquecer de removê-lo. Um roteiro para conferir se está tudo certo:
- Inspecione os cabeçalhos HTTP: ferramentas de desenvolvedor do navegador ou verificadores de cabeçalho mostram se o X-Robots-Tag está presente e com qual valor.
- Garanta que a URL é rastreável: confirme que ela não está bloqueada no robots.txt, senão o buscador não lerá a diretiva.
- Use a inspeção de URL: a ferramenta de inspeção de URL do Search Console indica se o Google enxerga a página como excluída por uma diretiva noindex.
- Cheque o código de status: um código de status HTTP correto, junto do cabeçalho certo, evita sinais contraditórios para o robô.
O erro mais caro do X-Robots-Tag é o silencioso: um noindex esquecido numa regra ampla do servidor pode desindexar seções inteiras sem que ninguém perceba de imediato. Revisar os cabeçalhos após qualquer mudança de infraestrutura é a melhor forma de prevenção.