
Robots.txt: o que é e como usar o arquivo no seu site
Por Tiago CostaAtualizado em 2 de julho de 2026

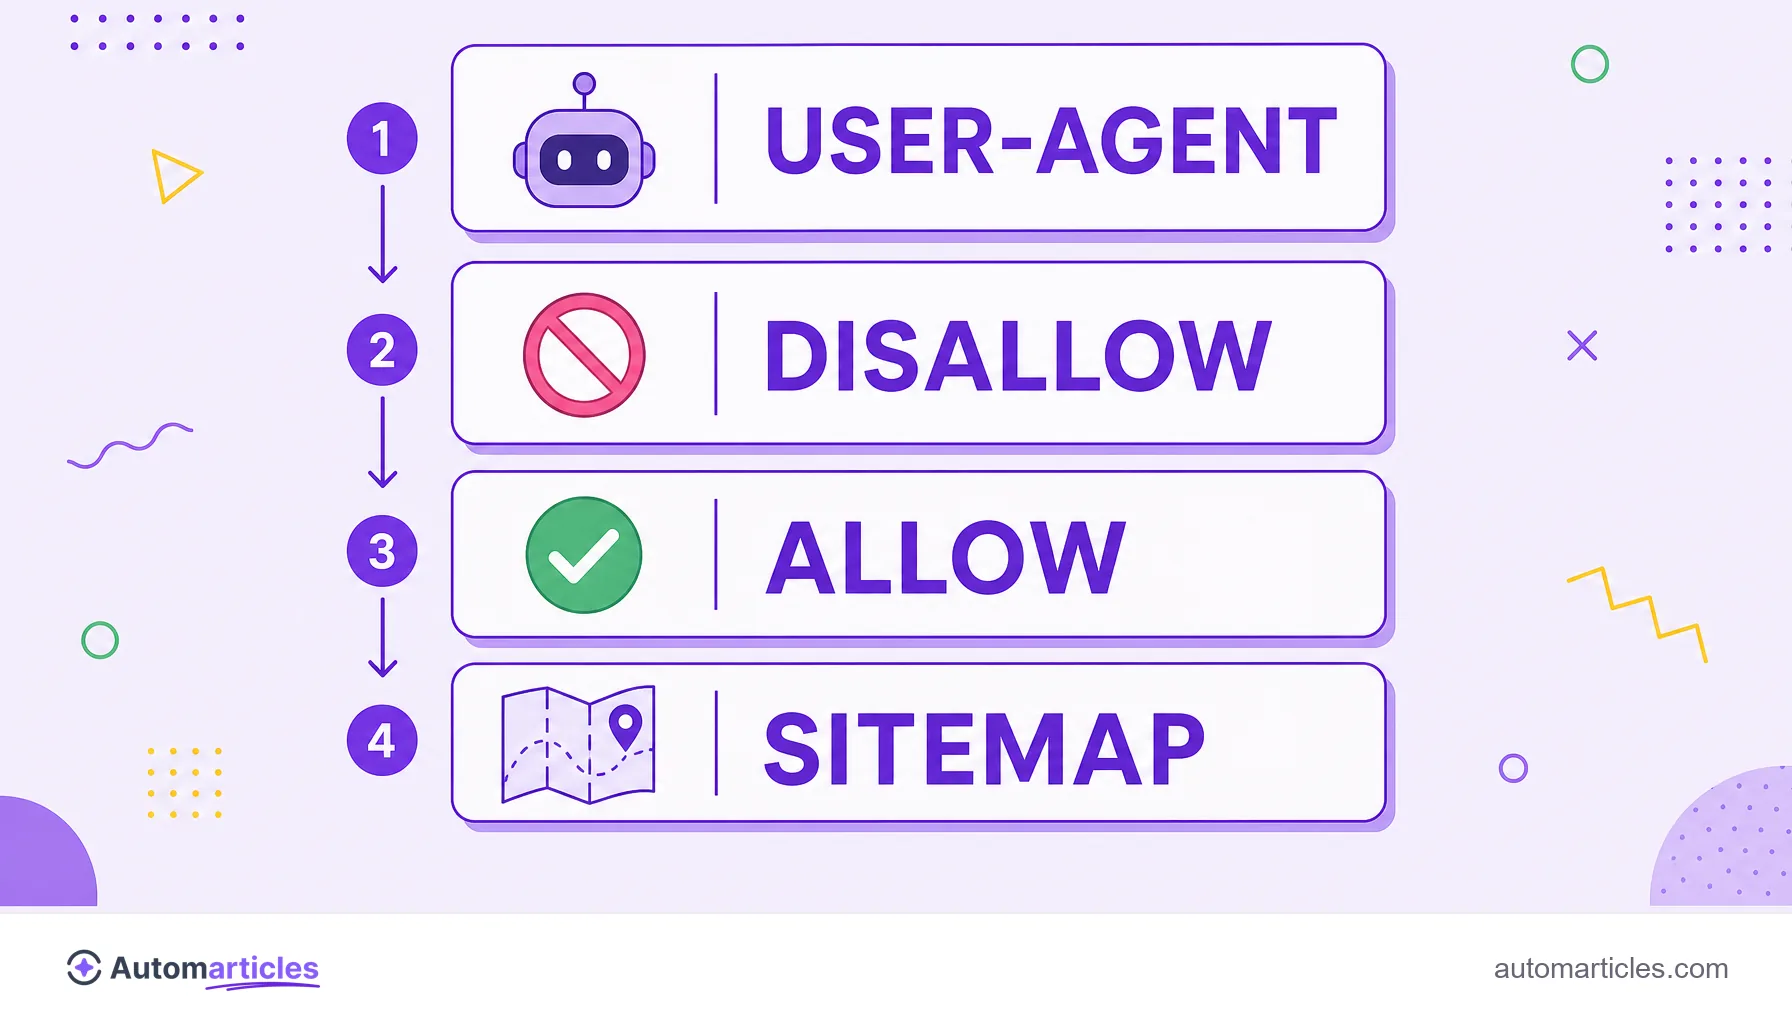
Robots.txt é um arquivo de texto simples, salvo na raiz do domínio (em seudominio.com/robots.txt), que orienta os robôs dos buscadores sobre quais partes do site eles podem rastrear. Ele costuma conter:
- uma linha User-agent que nomeia o robô alvo;
- regras Disallow para os caminhos que não devem ser rastreados;
- regras Allow que abrem exceções;
- uma linha Sitemap que aponta o mapa do site.
O que é o arquivo robots.txt
Robots.txt é um arquivo de texto simples, salvo na raiz do domínio (em seudominio.com/robots.txt), que orienta os robôs dos buscadores sobre quais partes do site eles podem ou não rastrear. Ele é a porta de entrada que todo crawler educado consulta antes de percorrer as páginas.
O arquivo segue o Protocolo de Exclusão de Robôs (REP, na sigla em inglês), um padrão criado em 1994 e adotado por praticamente todos os buscadores. As regras são públicas: qualquer pessoa pode abrir o robots.txt de um site digitando o endereço no navegador.
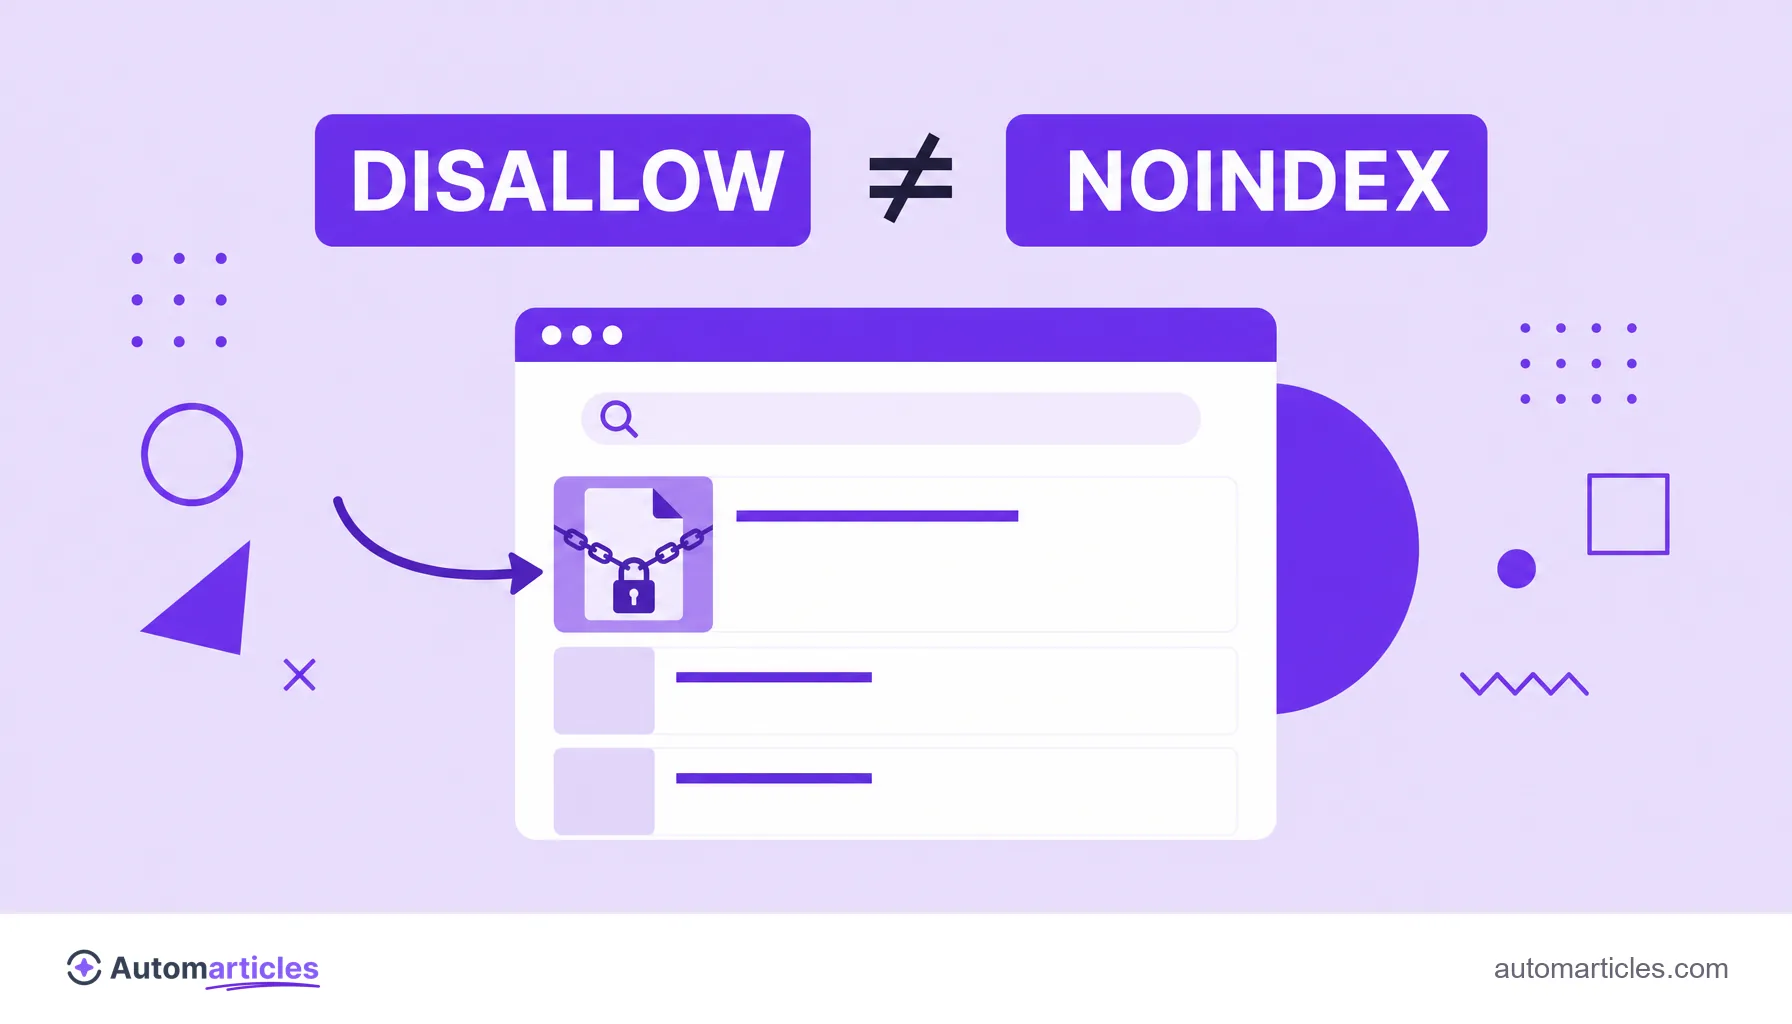
Vale entender o papel dele desde já: o robots.txt controla o rastreamento, não a indexação. Ou seja, ele diz por onde o robô pode andar, mas não é a ferramenta certa para esconder uma página dos resultados de busca.
Como o robots.txt funciona na prática
Sempre que um buscador visita um site, a primeira coisa que o motor de busca faz é procurar o arquivo em /robots.txt. Se ele existe, o robô lê as instruções e as respeita; se não existe, o robô assume que pode rastrear tudo.
As regras são organizadas em blocos, cada um começando por um User-agent (o robô alvo) seguido de linhas Disallow e Allow. Um exemplo típico:
- User-agent: * aplica a regra a todos os robôs;
- Disallow: /admin/ pede que não rastreiem a pasta de administração;
- Allow: /admin/ajax.php abre uma exceção dentro da pasta bloqueada;
- Sitemap: https://seudominio.com/sitemap.xml aponta o mapa do site.
É importante lembrar que essas regras são uma orientação, não uma trava. Robôs legítimos como o Googlebot obedecem, mas robôs maliciosos podem simplesmente ignorar o arquivo.
Sintaxe e principais diretivas
O robots.txt aceita um conjunto pequeno de diretivas. Conhecer cada uma evita bloqueios acidentais:
| Diretiva | O que faz |
|---|---|
| User-agent | Define a qual robô as regras seguintes se aplicam (use * para todos). |
| Disallow | Indica um caminho que o robô não deve rastrear. |
| Allow | Libera um caminho específico dentro de uma área bloqueada. |
| Sitemap | Informa a URL do sitemap XML para ajudar na descoberta de páginas. |
Há limites técnicos a respeitar. Segundo a documentação do Google Search Central, o Googlebot processa apenas os primeiros 500 kibibytes (cerca de 512 KB) de um arquivo robots.txt e ignora tudo o que vier depois desse limite. Diretivas antigas como Crawl-delay, aliás, não são interpretadas pelo Google.
Robots.txt não bloqueia a indexação
Esse é o mal-entendido mais caro do robots.txt. Bloquear uma página com Disallow impede o robô de ler o conteúdo, mas não garante que ela fique fora do Google. Se outras páginas apontam links para ela, o buscador pode indexar a URL mesmo sem rastreá-la, exibindo o resultado sem descrição.
A própria documentação do Google Search Central avisa que o robots.txt não serve para manter uma página fora dos resultados de busca. Para isso existe a diretiva noindex, aplicada na própria página.
Há ainda uma armadilha: se você bloqueia a página no robots.txt, o Google não consegue ler a tag noindex dentro dela e o comando nunca é obedecido. A regra prática para tirar algo da busca é o contrário do intuitivo: deixe o robô rastrear e use o noindex. Entender a diferença entre rastreamento e indexação resolve a maioria desses casos.
Onde fica o robots.txt e como criar no WordPress
O robots.txt fica sempre na raiz do domínio, acessível em seudominio.com/robots.txt. Não existe robots.txt por subpasta: cada domínio (e subdomínio) tem o seu.
No WordPress, o sistema gera um arquivo virtual automático quando não há um físico. Para assumir o controle, você pode:
- usar um plugin de SEO como Yoast ou Rank Math, que oferece um editor de robots.txt direto no painel;
- criar um arquivo físico chamado robots.txt na pasta raiz da instalação, via FTP ou gerenciador de arquivos;
- ativar a opção de robots.txt personalizado do plugin, que substitui o arquivo virtual pelas suas próprias regras.
Ativar o robots.txt personalizado significa justamente trocar o arquivo padrão gerado pela plataforma por uma versão editável, em que você define manualmente o que liberar e o que bloquear.
Erros comuns e boas práticas
Por ser um arquivo pequeno e poderoso, o robots.txt causa estragos quando mal configurado. Os deslizes mais frequentes:
- Bloquear o site inteiro: um Disallow: / esquecido após o desenvolvimento tira todas as páginas do rastreamento.
- Bloquear CSS e JavaScript: impedir esses arquivos atrapalha o Google a renderizar a página e pode prejudicar a avaliação.
- Confiar no robots.txt para privacidade: como o arquivo é público, listar pastas sensíveis nele acaba entregando o caminho.
- Esquecer o sitemap: incluir a linha Sitemap ajuda o buscador a descobrir suas URLs mais rápido.
Depois de qualquer alteração, teste o arquivo no Google Search Console e trate o robots.txt como parte da sua rotina de SEO técnico. Um bom uso também ajuda a direcionar o orçamento de rastreamento para as páginas que realmente importam.