
ClaudeBot: o que é o crawler da Anthropic e como controlar o acesso ao seu site
Por Tiago CostaAtualizado em 2 de julho de 2026

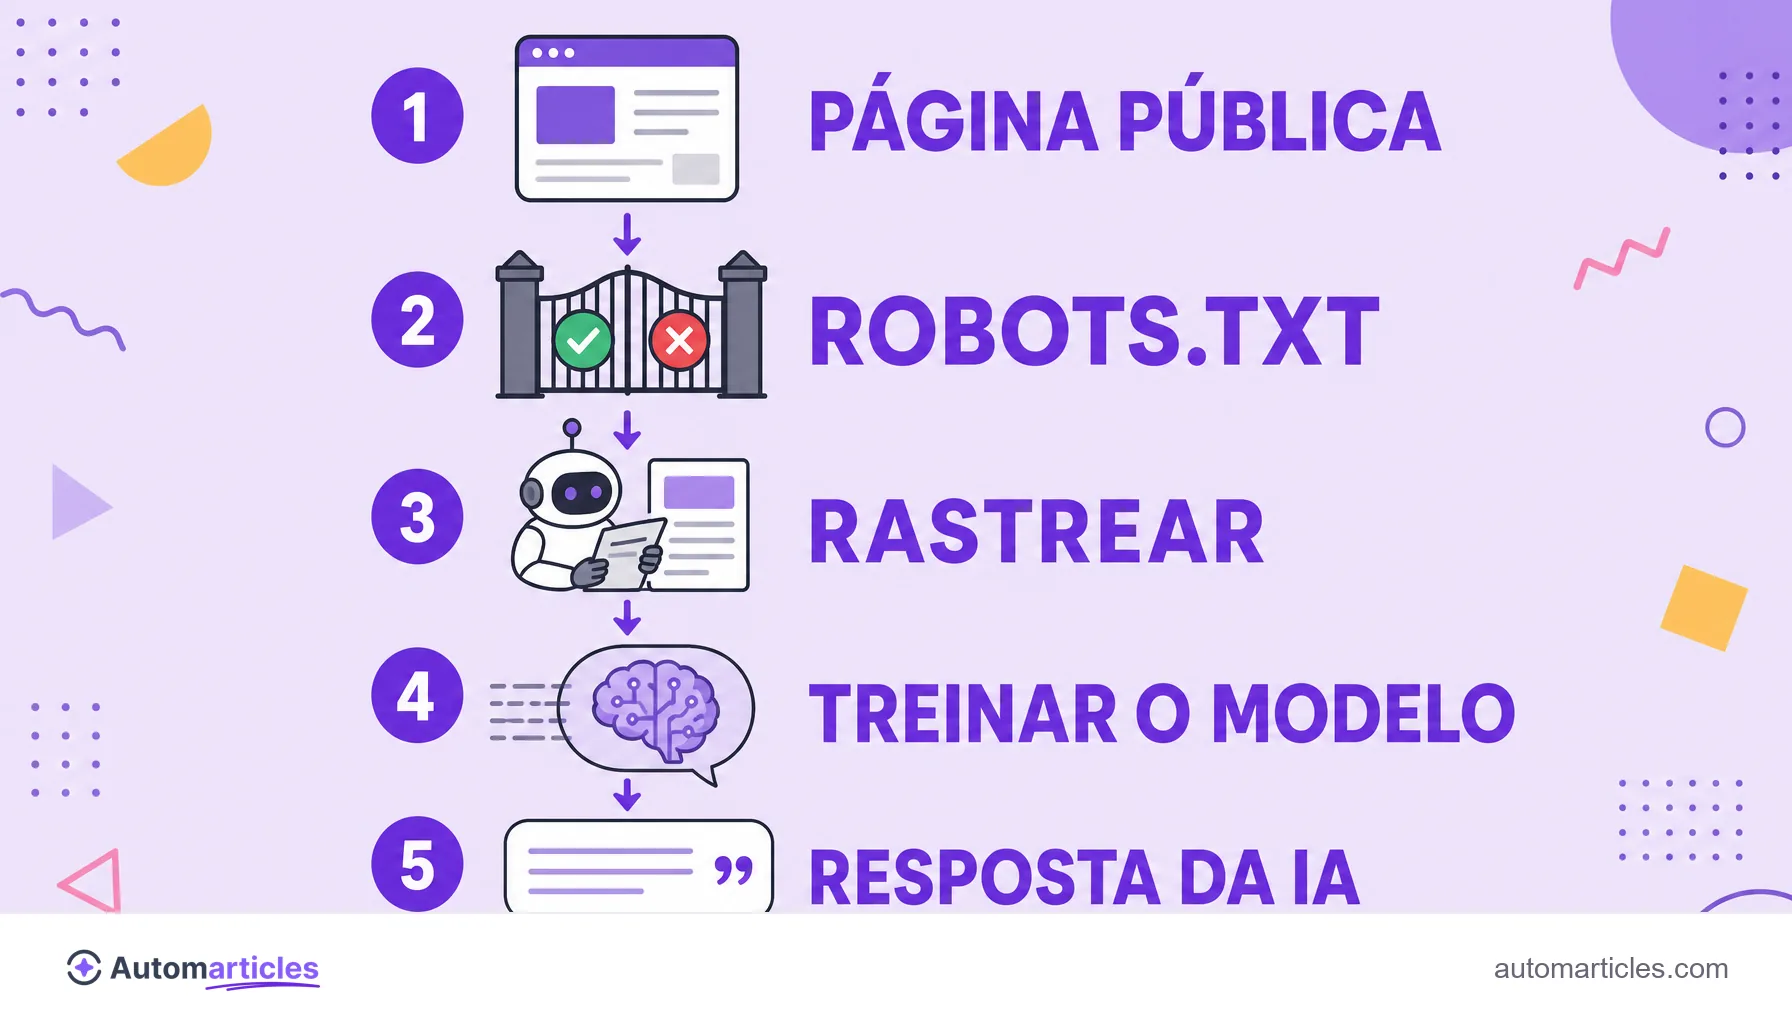
ClaudeBot é o rastreador oficial da Anthropic, empresa criadora do assistente Claude. Na prática, o ClaudeBot:
- visita páginas públicas da web e lê o conteúdo delas;
- coleta esse material para treinar e informar os modelos Claude;
- se identifica pelo user-agent ClaudeBot nos registros do servidor;
- respeita as regras do robots.txt, então pode ser liberado ou bloqueado.
O que é o ClaudeBot
O ClaudeBot é o rastreador automatizado da Anthropic, a empresa responsável pela família de modelos e pelo assistente de IA chamado Claude. A função dele é simples de descrever e enorme em escala: percorrer a web pública, baixar páginas e extrair texto que serve de matéria-prima para treinar e alimentar os modelos da Anthropic.
Na hierarquia dos robôs da internet, o ClaudeBot é um crawler como qualquer outro. A diferença é o destino do que ele coleta. Enquanto o Googlebot lê páginas para montar o índice de um buscador, o ClaudeBot lê páginas para que um modelo de linguagem aprenda com elas e consiga responder perguntas com mais contexto. É a mesma mecânica de rastreamento a serviço de um objetivo novo: a inteligência artificial generativa.
Para quem tem site, o ponto importante é que o ClaudeBot não é oculto nem misterioso. Ele se anuncia, publica suas faixas de IP e obedece às instruções que você deixa no servidor. Ou seja, você tem controle sobre o que ele pode ou não acessar.
Qual é o user-agent do ClaudeBot
Todo bem-comportado rastreador se identifica por uma linha de texto chamada user-agent, que aparece nos registros (logs) de acesso do servidor. O user-agent do rastreador de treino da Anthropic contém a palavra ClaudeBot, num formato parecido com ClaudeBot/1.0 seguido de um endereço de contato da Anthropic.
Vale saber que a Anthropic opera mais de um agente, cada um com um propósito diferente:
- ClaudeBot: o rastreador amplo, que coleta conteúdo público para treinar os modelos.
- Claude-User: aciona uma busca quando uma pessoa, dentro do Claude, faz uma pergunta que exige consultar a web em tempo real.
- anthropic-ai: identificador mais antigo, ainda citado em alguns registros.
Saber distinguir esses nomes ajuda a ler os logs com precisão e a escrever regras certeiras. Bloquear apenas o ClaudeBot, por exemplo, tem um efeito diferente de bloquear o agente que busca a pedido do usuário.
Como permitir ou bloquear o ClaudeBot no robots.txt
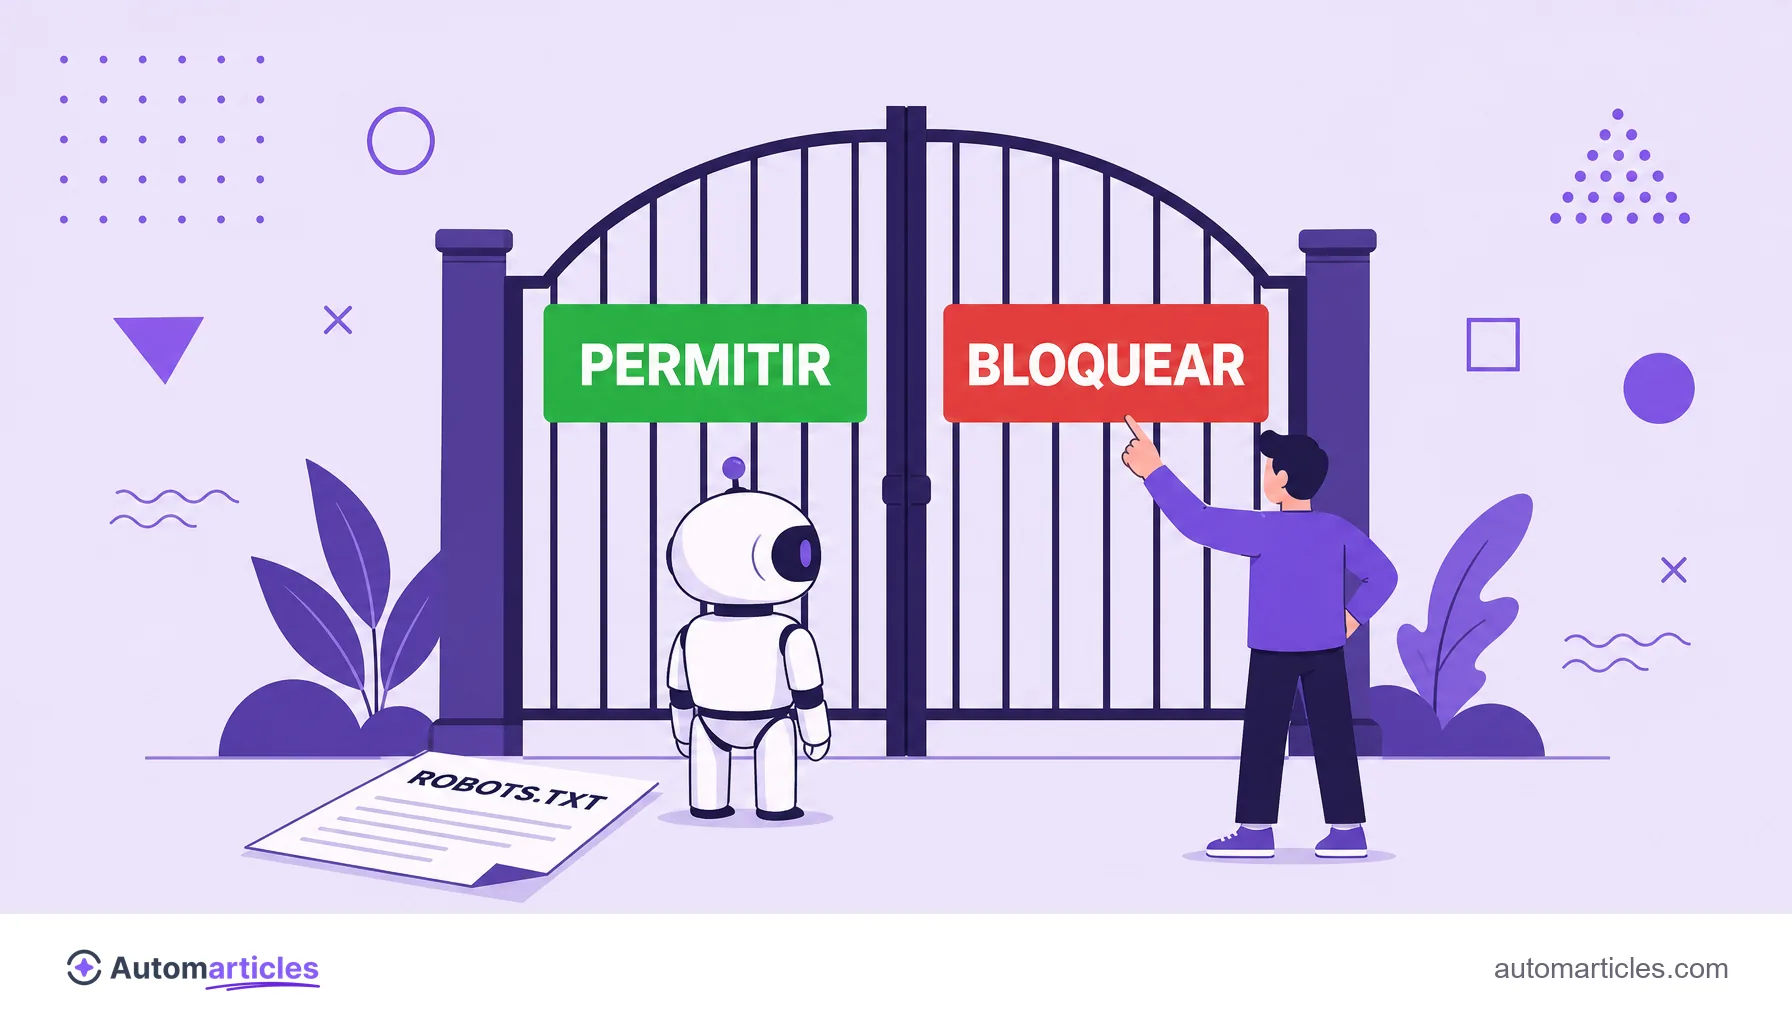
O controle mais direto sobre o ClaudeBot mora no arquivo de robots.txt, que fica na raiz do site e diz aos robôs o que eles podem ou não rastrear. As regras são escritas por user-agent.
Para bloquear totalmente o ClaudeBot, adicione:
- User-agent: ClaudeBot
- Disallow: /
Para liberar o acesso, basta não criar nenhuma regra de bloqueio para ele, ou ser explícito com Allow: /. Como o ClaudeBot respeita o protocolo, um Disallow bem escrito é suficiente para tirá-lo do seu site sem precisar de firewall.
Um cuidado que evita dor de cabeça: robots.txt é uma orientação pública, e só funciona com robôs que escolhem obedecer. O ClaudeBot obedece, mas rastreadores mal-intencionados ignoram o arquivo. Se a intenção é barrar bots que não cooperam, o robots.txt precisa de reforço no nível do servidor ou de um firewall de aplicação.
Bloquear o ClaudeBot vale a pena? Treino, direitos e tráfego
A decisão de liberar ou barrar o ClaudeBot não tem resposta única. Ela depende do que o seu conteúdo representa para o negócio e do que você espera receber em troca do acesso.
Há um argumento forte a favor do bloqueio: dados sobre a economia do rastreamento de IA mostram uma troca muito desigual. Segundo a análise de tráfego da Cloudflare, em julho de 2025 os rastreadores da Anthropic visitaram cerca de 38 mil páginas para cada visitante que a empresa devolveu a um site (uma proporção que já foi de 286 mil para 1 em janeiro do mesmo ano). Em outras palavras, o bot lê muito e encaminha pouca gente de volta.
Por outro lado, bloquear tem um custo: seu conteúdo deixa de ter chance de informar as respostas do Claude, um assistente com base de usuários grande e crescente. A escala do ClaudeBot dá a dimensão da aposta. A mesma Cloudflare apontou que o ClaudeBot chegou a responder por cerca de 21% de todo o tráfego de rastreadores de IA na sua rede. A pergunta prática é: você quer estar presente nesse universo ou proteger o conteúdo do treino?
ClaudeBot e GEO: aparecer (ou não) nas respostas de IA
É aqui que o ClaudeBot encontra o GEO (Generative Engine Optimization), a disciplina de otimizar conteúdo para ser citado e usado por buscadores e assistentes de IA. A lógica é direta: se o Claude nunca leu o seu material, dificilmente ele vai mencionar a sua marca ou usar os seus argumentos ao responder um usuário.
Liberar o ClaudeBot é, portanto, o primeiro passo para se tornar elegível a esse tipo de citação por IA. Não garante nada sozinho, mas é a porta de entrada. A partir daí, valem as boas práticas de otimização para motores generativos: respostas objetivas logo no início, dados com fonte clara, estrutura escaneável e definições fáceis de extrair.
Um recurso complementar vem ganhando espaço nesse contexto: o arquivo de llms.txt, proposto como um guia para modelos de linguagem sobre qual conteúdo do site priorizar. Ele não substitui o robots.txt, mas sinaliza intenção e organização para quem quer ser bem representado pelas IAs, em vez de apenas bloqueá-las.
Como confirmar que o acesso é mesmo do ClaudeBot
Nem todo acesso que se diz ClaudeBot é legítimo. Como o user-agent é apenas um texto, qualquer script pode copiá-lo para se passar pelo bot da Anthropic. Por isso, antes de tomar decisões com base nos logs, vale confirmar a origem.
A verificação segue o mesmo princípio usado para o Googlebot:
- Cheque a faixa de IP: a Anthropic publica os intervalos de endereços de onde o ClaudeBot acessa. Um acesso que se diz ClaudeBot mas vem de fora dessas faixas é suspeito.
- Observe o comportamento: o bot legítimo respeita o robots.txt e controla o ritmo de acesso. Rajadas agressivas que ignoram suas regras não combinam com um rastreador oficial.
- Cruze com os registros: compare horários, volume e páginas acessadas para separar o rastreador real de um raspador disfarçado.
Esse cuidado é o que separa uma leitura precisa dos dados de uma reação a um falso positivo. Confirmar a identidade antes de bloquear evita tanto fechar a porta para o bot certo quanto deixar entrar o bot errado.