
TF-IDF: o que é e como funciona no SEO
Por Tiago CostaAtualizado em 2 de julho de 2026

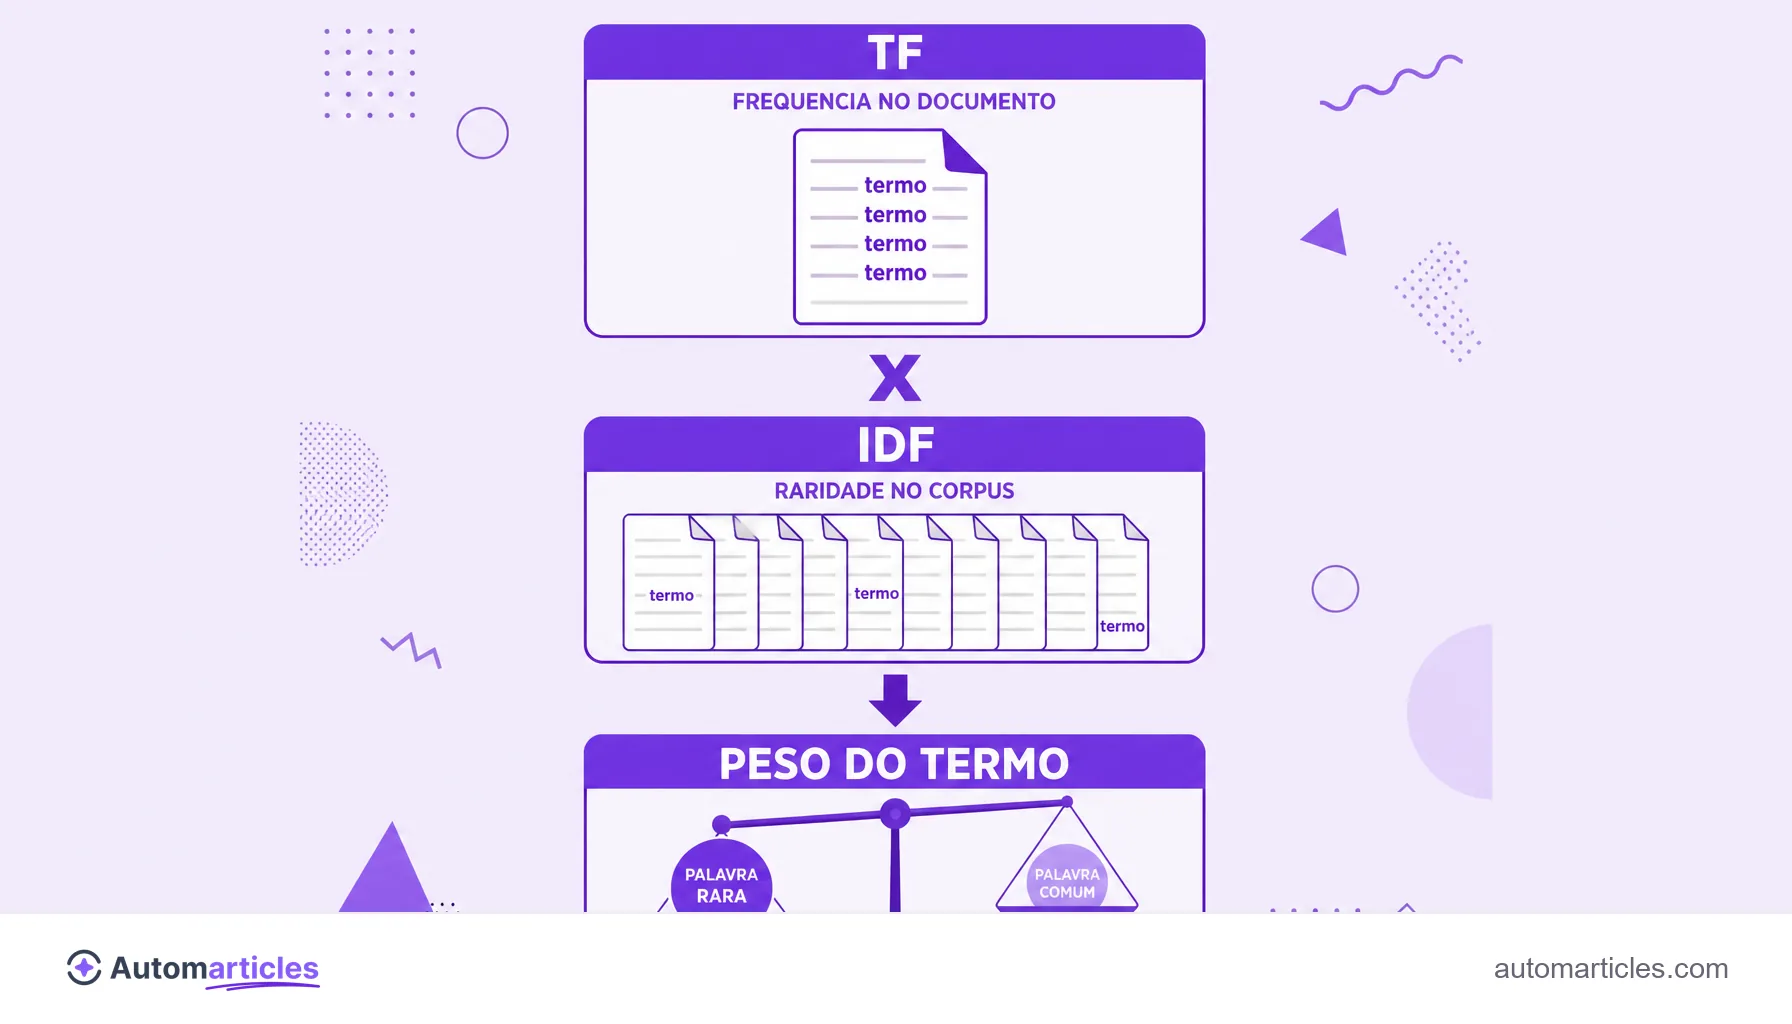
TF-IDF combina duas medidas para calcular o peso de uma palavra em um texto:
- TF (Term Frequency): quantas vezes o termo aparece no documento;
- IDF (Inverse Document Frequency): o quanto o termo é raro no corpus inteiro.
Multiplicando as duas, palavras frequentes na página e raras na web recebem peso alto, enquanto palavras comuns como "de" e "para" recebem peso baixo.
O que é TF-IDF e o que significa a sigla
TF-IDF é a sigla de Term Frequency, Inverse Document Frequency, ou frequência do termo pela frequência inversa nos documentos. Trata-se de uma medida estatística clássica da recuperação de informação, criada para responder a uma pergunta simples: dentro de um texto, quais palavras realmente importam para descrever o assunto?
A intuição é fácil de captar. Se a palavra fotossíntese aparece várias vezes em um artigo e quase não aparece nos outros textos da coleção, ela é um ótimo indício do tema daquele artigo. Já palavras como de, que e para aparecem em quase tudo, então não ajudam a distinguir um documento do outro e recebem peso baixo.
Por isso o TF-IDF virou base de motores de busca antigos, filtros de spam e sistemas de recomendação. Ele transforma texto em números que podem ser comparados, o primeiro passo para uma máquina entender do que uma palavra-chave está falando.
Como funciona a fórmula do TF-IDF
O TF-IDF é o produto de dois componentes calculados separadamente e depois multiplicados.
O TF (Term Frequency) mede a frequência do termo no documento. Na forma mais comum, é o número de vezes que a palavra aparece dividido pelo total de palavras do texto, para não penalizar documentos curtos nem inflar os longos.
O IDF (Inverse Document Frequency) mede o quanto o termo é raro no corpus. Ele é o logaritmo do total de documentos dividido pelo número de documentos que contêm aquele termo. Quanto mais raro o termo, maior o IDF; quanto mais comum, mais o IDF se aproxima de zero.
O resultado final é TF x IDF. Uma palavra só alcança peso alto quando é frequente naquele texto e incomum no conjunto. Se ela é frequente em toda parte, o IDF derruba o valor. Se é rara na coleção, mas nem aparece no documento, o TF zera a conta.
TF-IDF na prática: um exemplo passo a passo
Imagine um corpus de 1.000 artigos de um blog. Você quer saber o peso das palavras em um post sobre café especial. Veja três termos desse post:
| Termo | Aparições no post | Documentos com o termo | Peso relativo |
|---|---|---|---|
| de | 40 | 1.000 | Baixo |
| café | 18 | 300 | Médio |
| torra | 9 | 25 | Alto |
A palavra de aparece muito, mas está em todos os 1.000 documentos, então o IDF a leva quase a zero. Café é relevante, porém aparece em boa parte do blog, o que reduz seu peso. Já torra, presente em só 25 textos, ganha o maior peso relativo: é ela que melhor caracteriza aquele post específico.
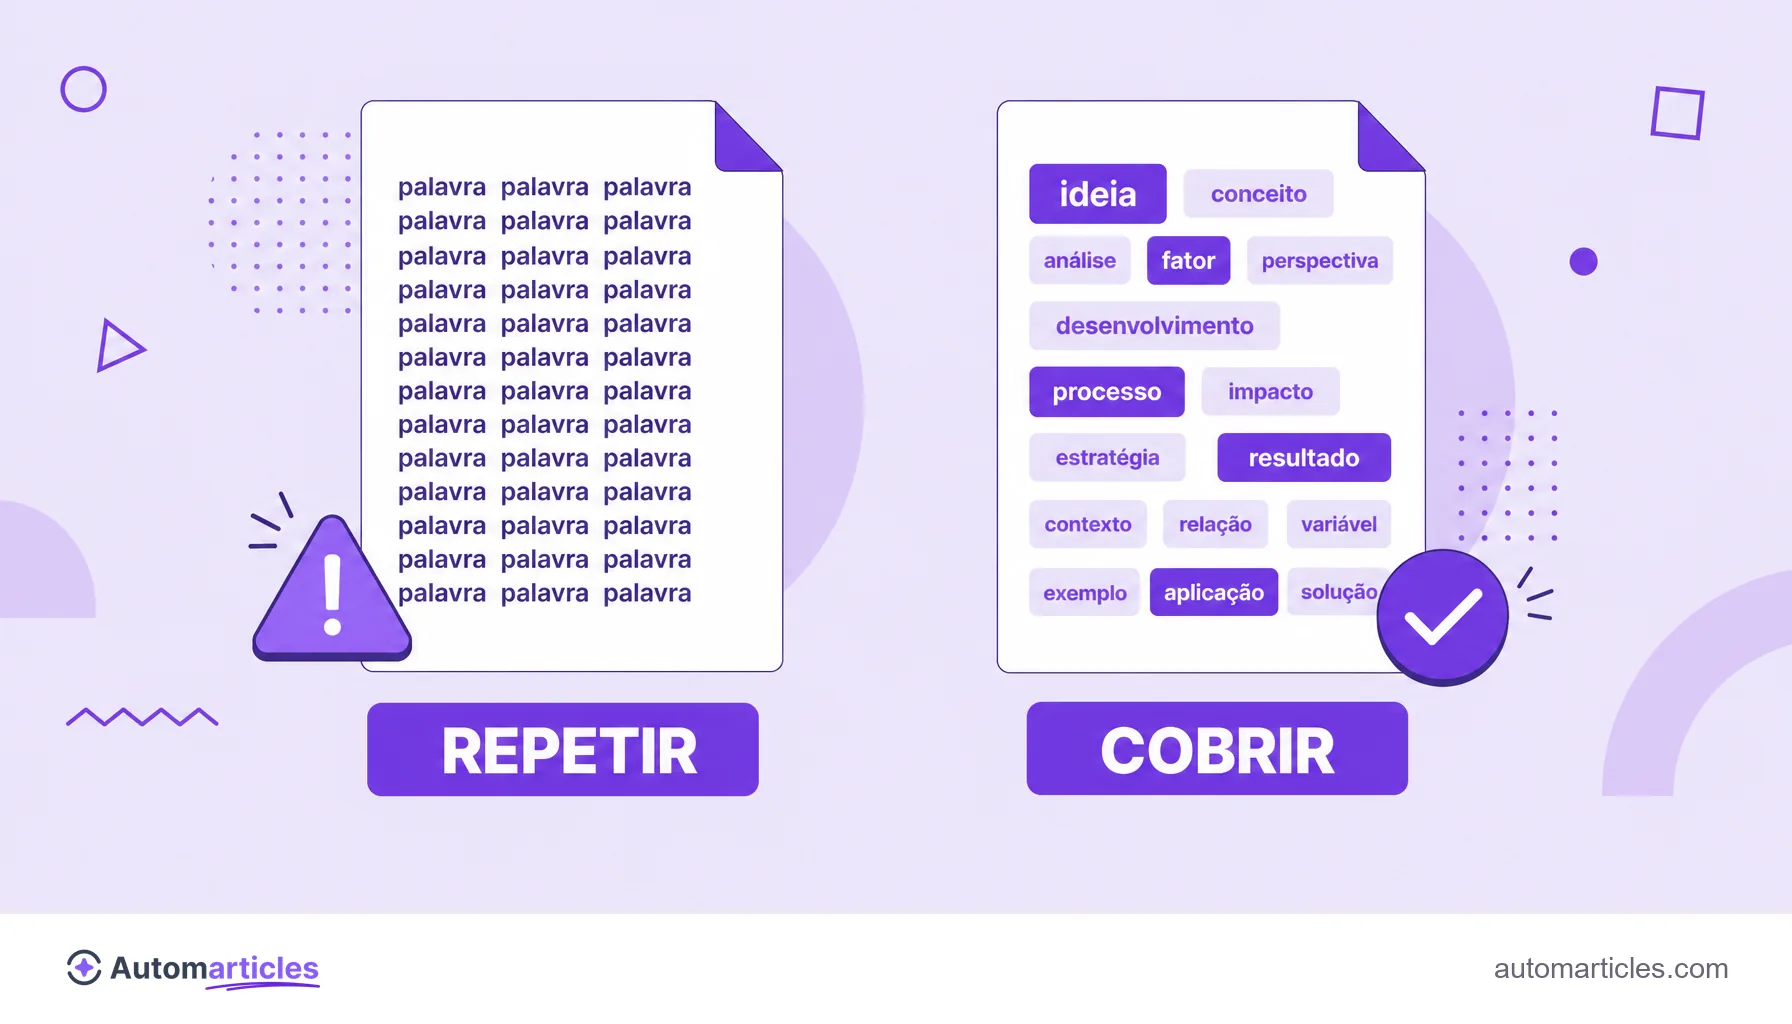
Esse raciocínio explica por que encher o texto com o termo principal não funciona. Repetir a palavra alvo aumenta o TF, mas não muda o IDF, e ainda esbarra no keyword stuffing, a repetição artificial de palavras. O que enriquece o conteúdo é a presença natural dos termos de apoio, os que dão profundidade ao tema.
TF-IDF em SEO: para que serve de verdade
Vale um alerta importante: o TF-IDF não é um fator de ranqueamento direto do Google. O próprio Google já minimizou seu peso. Em declarações compiladas pelo Search Engine Journal, John Mueller descreveu o TF-IDF como uma métrica muito antiga e afirmou que ela nem é totalmente calculável, pois dependeria das estatísticas da web inteira. O buscador moderno usa modelos de linguagem e sinais bem mais sofisticados.
Ainda assim, o raciocínio por trás do TF-IDF continua útil como ferramenta de análise. Ele ajuda a mapear o vocabulário que os conteúdos que já ranqueiam usam para cobrir um tema, revelando termos de apoio que talvez faltem no seu texto. É um apoio ao SEO semântico, não um alvo em si.
Na prática, ferramentas de otimização de conteúdo usam variações do TF-IDF para sugerir palavras relacionadas. O erro é tratar a lista como meta a bater. O uso saudável é usá-la como checklist de cobertura: se o tema pede subtópicos que você esqueceu, o TF-IDF acende a luz.
TF-IDF, densidade de palavra-chave e LSI: o que é diferente
Esses três conceitos são fáceis de confundir, mas medem coisas distintas.
- TF-IDF: pesa um termo no documento contra um corpus inteiro. É relativo e considera o restante da coleção.
- Densidade de palavra-chave: a densidade de palavra-chave é só a porcentagem de vezes que um termo aparece em um texto, sem comparar com nada externo.
- LSI: o conceito de LSI (indexação semântica latente) tenta descobrir relações de significado entre termos, indo além da contagem simples.
Na escala e no idioma da web real, nenhum desses cálculos é feito da forma pura que os manuais descrevem. Eles servem melhor como modelos mentais: o TF-IDF lembra que relevância é relativa, a densidade alerta contra exagero, e o LSI reforça a ideia de cobrir um tema por significado, não por repetição.
Como usar o raciocínio do TF-IDF no seu conteúdo
Você não precisa calcular logaritmos para se beneficiar da ideia. Um roteiro prático:
- Estude quem já ranqueia: liste os termos de apoio recorrentes nos textos do topo e veja o que falta no seu.
- Cubra o tema, não a palavra: em vez de repetir o termo alvo, traga variações, sinônimos e subtópicos que o assunto pede.
- Evite o exagero: repetir a palavra principal não aumenta a relevância percebida e pode configurar spam.
- Escreva para pessoas: um texto que responde bem à dúvida costuma incluir os termos certos de forma natural.
- Use ferramentas como apoio, não como regra: listas de termos sugeridos ajudam a lembrar lacunas, mas o critério final é a clareza para o leitor.
No fim, o TF-IDF é mais valioso como forma de pensar do que como número a perseguir. Cobrir um assunto com profundidade e vocabulário rico é o que o buscador recompensa, com ou sem a fórmula na mão.